YouTube 观看历史数据分析
我现在看视频主要集中在 YouTube 和 Bilibili 两个网站。前者的观看体验比后者更胜一筹,基本上一回家我就打开 YouTube 了,即使不看也放着当生活的背景音。
昨晚看到自己订阅的博主有篇新文章——YouTube 观看历史分析,里面对 YouTube 优势的阐述和对视频这种信息获取方式的一些观点简直是和我不谋而合。
但最有意思的是他对自己观看记录进行了数据分析,知道了自己时间具体分配到了哪些频道。我看完几乎是没有丝毫等待,就按他的方法操练起来了。之后在他的基础上,我自己画了个 Wordle(词云),可以清晰的看出自己对某类视频的钟爱……
分析结果可视化
数据的收集、存储、分析,都已经在Yi's Blog提供,按照他的步骤可得到以下结果:
观看时长分布

左图可以清晰的看出从 2017 年开始我在 YouTube 上花费的时间每年翻一倍,2019 年看了接近 3500 个视频……
再看右图,简直可以看出我 2019 年的作息习惯:
- 每天 20 点基本上就是吃完饭回到家坐在电脑前了
- 从 20 点到 24 点期间,可能会做一些自己的事,做完才打开 YouTube
- 0 点到 2 点是我彻底放松的时间,观看 YouTube 时长最长,偶尔会一路熬夜到凌晨 5 点(请大家珍惜生命)
视频时长分布

我看的视频大部分在 20 分钟以内,其实这也和“YouTube 火爆视频都是 5-10 分钟的时长”相符。然后有一部分 40 分钟左右的视频,很明显我这是在看电视剧……
视频关键字可视化
根据你仅仅是在 Google Takeout 里下载了观看历史数据,也可以直接进行我这步的分析,代码附在本文末尾。
紧接着我尝试分析了我 2019 年常看视频的关键词。思路比较简单,从标题中分词,再按关键字生成词云。分词最常用的就是 结巴分词,词云生成我选用了 word_cloud,Python 搞这类数据分析真是吹枯拉朽,简单几行代码即可搞定。
最开始我尝试直接用
tags = jieba.cut(title) # title 就是每个看过的视频标题发现效果并不好,如下图
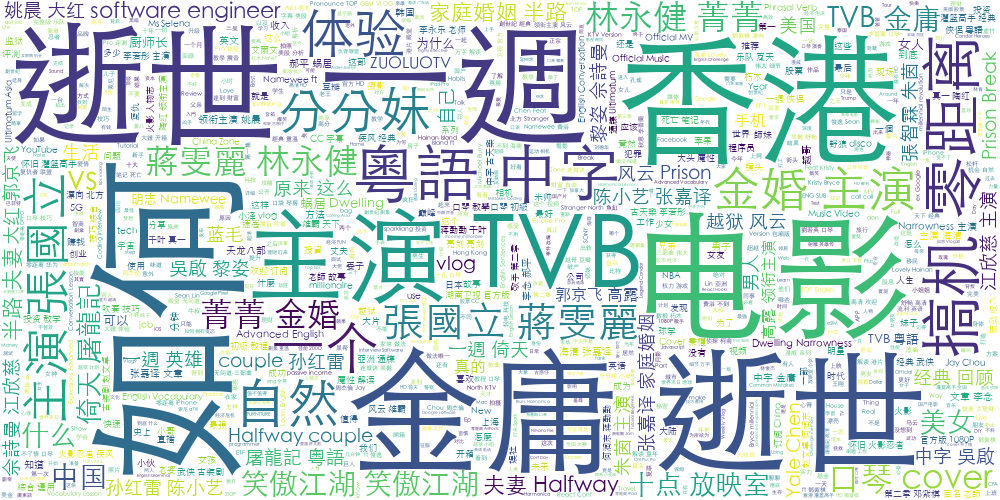
不过看这个已经可以看出我对金庸武侠电视剧的钟爱了,因为金庸老先生逝世,所以很多频道在每个视频标题前都加上了【金庸逝世一週年】的字段,于是出现图中的样子。还出现了很多演员的名字,是因为很多频道为了搜索优化,把所有主演的名字写在了标题里。其次像“如何”这类词也无实际意义,需要去掉。“自然”这个词,我看到的时候也愣了一下,按理来说我不在 YouTube 上看这类视频啊,后来反应过来这应该是一个 Up 主的名字被强行分词了。
于是我调整策略,采用基于 TF-IDF 算法的关键词抽取:
tags = jieba.analyse.extract_tags(title)把无意义的词用 stop_words 列表来过滤掉:
jieba.analyse.set_stop_words('./stop_words.txt') # 过滤掉主演、如何、到底、一个、就是、等等这类无意义词同时,我把频道名算作一个词,在结巴分词时提高它的词频:
for subtitle in history["subtitles"]:
  jieba.add_word(subtitle["name"])
jieba.suggest_freq(subtitle["name"], True)最后把一些词微调,也提高它的词频,保证它不被强行切分(比如我钟爱的搞机零距离,和各类武侠片片名等)。
最终版效果图如下:
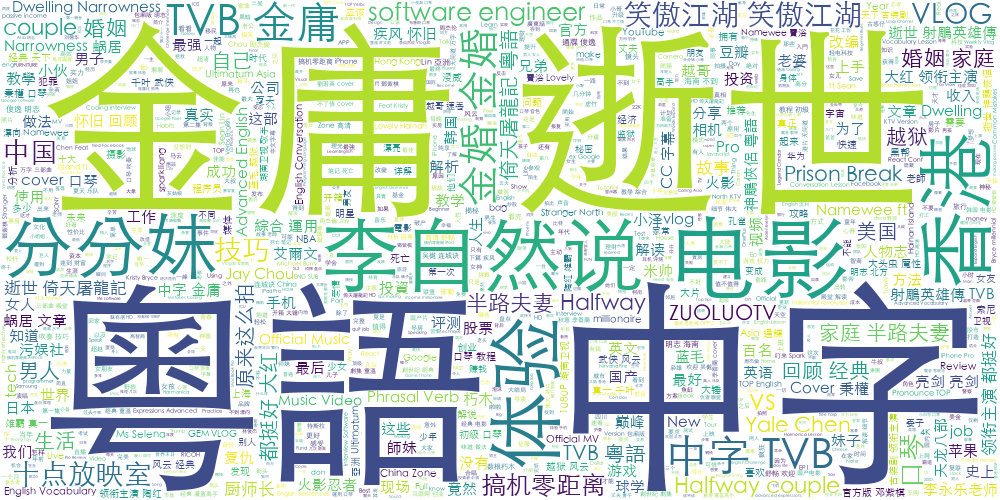
jieba.del_word('金庸逝世') 也无法将这两个词分开,“粤语中字”也是,不知为何;即使把 TVB 这个单词的词频调高也没法和其他词分开虽然不完美,但结论显而易见了。
- 看的最多的就是金庸武侠电视剧,笑傲江湖应该是我看的次数最多的,接下来倚天、射雕、天龙、神雕。说实话我在结果出来之前是没有意识到自己花了这么多时间在不断回看这些片子上……我也搞不懂,为什么即使看了无数遍,我还是看得津津有味
- 李自然说是讲创业和商业逻辑的,每个视频几乎都看了
- 分分妹 猎奇的方式解说各种男女电影,适合污污的你
其实这两个词能在词云中凸显出来是因为他们俩每个视频的标题都含有相同关键字。另一方面,虽然从图中看到我好像看的都是电视剧,那是因为电视剧的每个视频名字是重复的,只有集数不同,所以词频高。
常看的 YouTube 频道
接下来还是直接靠统计数据来解答我到底常看哪些频道吧。下表是我观看视频数量最多的 25 个频道。看完后的感想是:
| 排名 | 频道 | 观看视频数量 |
|---|---|---|
| 1 | TechLead | 254 |
| 2 | 中国好声音官方频道SING!CHINA Official Channel | 250 |
| 3 | TVB WuXia Drama 經典武俠頻道 | 224 |
| 4 | 优优独播剧场——YoYo Television Series Exclusive | 132 |
| 5 | Speak English With Vanessa | 124 |
| 6 | 钟文泽 | 120 |
| 7 | ZUOLUOTV | 98 |
| 8 | 李自然说 | 87 |
| 9 | Abed C3 | 82 |
| 10 | Spark Liang 张开亮 | 79 |
| 11 | 浙江卫视音乐频道 ZJSTV Music Channel | 78 |
| 12 | 李永乐老师 | 75 |
| 13 | 分分鐘電影大咖 | 73 |
| 14 | Chaoteng Chang | 65 |
| 15 | 郝给力 | 64 |
| 16 | Maaaxter English | 62 |
| 17 | China Zone 剧乐部 | 60 |
| 18 | 大劇獨播MZTV | 60 |
| 19 | 四季萌芽 | 58 |
| 20 | 左手+ | 58 |
| 21 | 茒永泰 | 56 |
| 22 | 数根朽木 | 55 |
| 23 | CYFIT兆佑 | 52 |
| 24 | 美食作家王刚 | 52 |
| 25 | Yale Chen | 50 |
下表则是我观看时长最长的 25 个频道,但是由于数据里没有我到底看了视频哪一截的数据,所以这里假定我每个视频都是从头到尾看完的。
- 排名第一的这个频道 Abed C3,其实是播《笑傲江湖》的……
- React Conf 我应该是看了很多 Talk,但是不一定每个都看完了,很多讲的没意思就跳出了
| 排名 | 频道 | 观看时长(小时) |
|---|---|---|
| 1 | Abed C3 | 63.55 |
| 2 | React Conf | 54.88 |
| 3 | TechLead | 48.77 |
| 4 | China Zone 剧乐部 | 47.63 |
| 5 | Speak English With Vanessa | 41.02 |
| 6 | 熱點劇場Hotspot! | 34.76 |
| 7 | 李自然说 | 33.90 |
| 8 | 浙江卫视【奔跑吧】官方频道 ZJSTV Keep Running Channel | 33.47 |
| 9 | 经典热播剧场 | 30.30 |
| 10 | 浙江卫视音乐频道 ZJSTV Music Channel | 28.87 |
| 11 | 优优经典剧场——YoYo Television Series Classic | 23.26 |
| 12 | JSConf | 22.06 |
| 13 | 中国好声音官方频道SING!CHINA Official Channel | 21.10 |
| 14 | 钟文泽 | 20.32 |
| 15 | 海润影视 | 19.98 |
| 16 | 华策影视官方频道 China Huace Film & TV Official Channel | 16.75 |
| 17 | Google Chrome Developers | 16.20 |
| 18 | 李永乐老师 | 16.15 |
| 19 | 数根朽木 | 14.91 |
| 20 | 分分鐘電影大咖 | 13.93 |
| 21 | 湖南卫视芒果TV官方频道 China HunanTV Official Channel | 13.26 |
| 22 | ZUOLUOTV | 13.24 |
| 23 | Baggers | 12.30 |
| 24 | 左手+ | 12.22 |
| 25 | 四季萌芽 | 11.98 |
尾
和刷微信、微博、Twitter、论坛(主要是 V2EX)一样,视频刷多了要自我反省。
我以前写过一篇我获取信息的渠道,但那大部分只写了阅读方面,现在音频(Podcasts)和视频(YouTube)也占了很大比重。YouTube 和 Netflix 良好的沉浸式体验,很容易就把时间偷走了。
如果不是这次分析,我可能没有意识到自己在它们上花了这么多时间,适时的量化自己,真的是很好的自省方式。
附:词云可视化代码
import json
import jieba.analyse
from wordcloud import WordCloud

json_file_path = './watch-history.json'

# with open('./stop_words.txt') as f:
#     stopWords = [line.strip() for line in f.readlines()]

def gen_img(texts, words_number):
  data = ' '.join(text for text in texts)
  wc = WordCloud(
      width=1000,
      height=500,
      background_color='white',
      max_words=words_number,
      font_path='/Library/Fonts/STHeiti Light.ttc'
  )
  wc.generate(data)
  wc.to_file('wordle.png')

def extract_words():
  words = []
  with open(json_file_path) as json_file:
    data = json.load(json_file)
    for history in data:
      if 'subtitles' not in history or 'titleUrl' not in history or not history['title'].startswith('Watched ') or not '2019' in history['time']:
        continue

      title = history['title'].replace('Watched ', '')

      for subtitle in history["subtitles"]:
        jieba.add_word(subtitle["name"])
        jieba.suggest_freq(subtitle["name"], True)

      # 这里你可以 jieba.add_word 或 del_word 一些词
      jieba.analyse.set_stop_words('./stop_words.txt')
      tags = jieba.analyse.extract_tags(title)
      # tags = jieba.cut(title)
      # tags = [t for t in tags if t not in stopWords]
      # print(tags)
      words.extend(tags)
  return words

def analyze():
  words = extract_words()
  print('words count: ', len(words))
  gen_img(words, len(words))

analyze()